LLM 스텔스 너프 현상과 엔터프라이즈의 진실: 동적 양자화 메커니즘과 유럽 규제 대응 전략
[핵심 요약]
- 출시 첫 주 찬사와 갑작스러운 성능 퇴보: 새로운 플래그십 AI 모델이 출시 초기에는 경이로운 성능을 보이다가 트래픽이 폭증하면 점차 엉뚱한 답변을 내놓는 '스텔스 너프(Stealth Nerf)' 현상이 개발자 커뮤니티의 최대 화두로 떠올랐습니다.
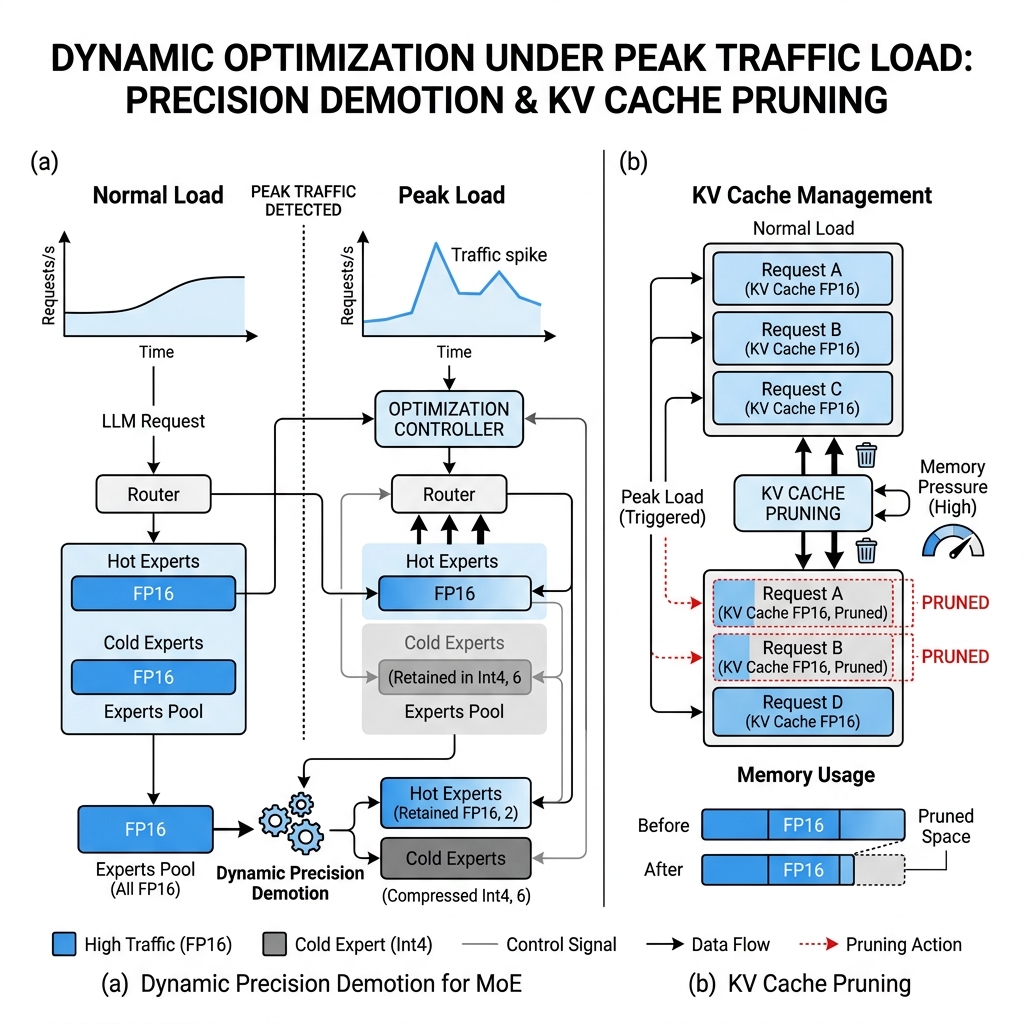
- 감춰진 기술적 원인: 모델 제공사들이 서버 비용과 GPU 메모리 고갈을 막기 위해 트래픽 급증 시 비활성 MoE 전문가 계층의 정밀도를 동적으로 강등(Dynamic Precision Demotion)하거나, KV 캐시 채널을 무리하게 가지치기(KV Cache Pruning)하면서 심층 추론 능력이 붕괴되는 것이 핵심 메커니즘입니다.
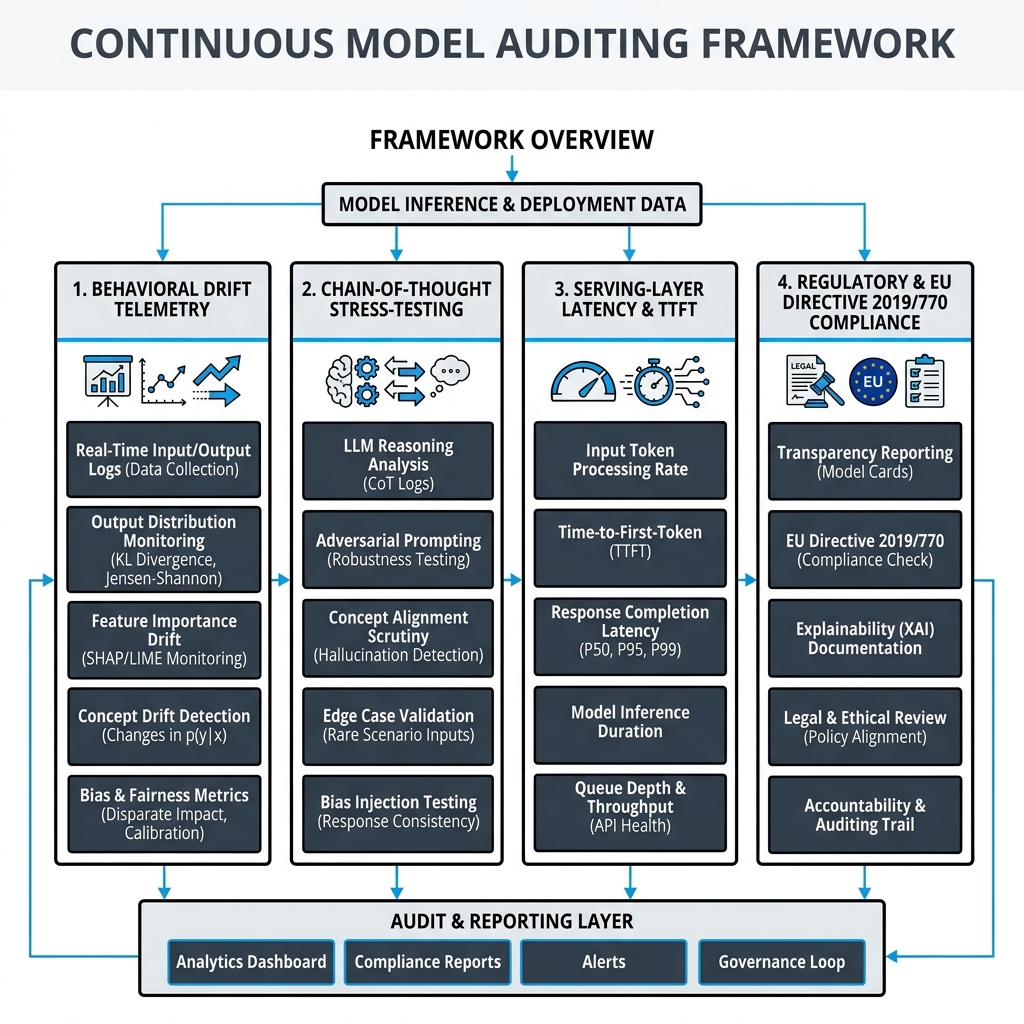
- 법적 규제와 대안: 유럽연합의 디지털 콘텐츠 지침(Directive 2019/770)에 따라 사전 고지 없는 성능 강등은 30일 이내 계약 해지 및 환불 대상이 될 수 있습니다. 이에 대응하여 기업들은 출시 첫날의 프롬프트를 주기적으로 자동 검증하는 '상시 모델 감사(Continuous Auditing)' 시스템을 필수적으로 구축해야 합니다.
[도입: 탄광 속 카나리아의 경고와 레딧의 폭로]
최근 레딧 r/ClaudeAI에 올라온 포스트 하나가 개발자들의 폭발적인 공감을 얻으며 770개 이상의 추천을 기록했습니다:
"Opus 5.5 nerfing - how to measure, how to spot, how to sue: Opus 5.5 was god-like in the first 5-6 days in my most complex C++ 3D engines, then suddenly it fluffed something more simple... High demand = lower speed. Quantisation and 'optimisations' kick in as demand increases."
(Opus 5.5의 성능 저하를 측정하고, 발견하고, 소송하는 법: 출시 초기 5~6일간은 신과 같았지만 트래픽이 늘자 급격히 단순한 실수들을 연발하기 시작했습니다. 수요 폭증은 곧 은밀한 양자화와 다운그레이드를 의미합니다.)
단순한 개인의 기분 탓일까요, 아니면 대규모 AI 클라우드 인프라의 피할 수 없는 공학적 타협일까요?
[기술적 본질: 트래픽 피크 시 작동하는 3대 다운그레이드 메커니즘]
빅테크 기업들이 사용자 모르게 서비스 뒷단에서 실행하는 주요 연산 절감 기법은 크게 세 가지로 분류됩니다.
1. 동적 정밀도 강등 (Dynamic Precision Demotion)
- 작동 원리: 대규모 MoE(Mixture of Experts) 모델은 수백억에서 수천억 개의 파라미터를 갖습니다. 평상시에는 16비트 부동소수점(FP16)이나 고정밀도로 서빙되지만, 동시 접속자가 폭증하면 시스템이 덜 자주 호출되는 '콜드(Cold)' 전문가 계층의 연산 정밀도를 Int4나 Int2 같은 초저비트(Sub-4-bit)로 실시간 강등합니다.
- 파급 효과: 일상적인 대화나 단순 번역에서는 차이가 드러나지 않지만, 수학적 증명이나 복잡한 소프트웨어 버그 수정처럼 희귀한 전문가 뉴런의 정밀도가 필수적인 작업에서는 치명적인 논리 헛발질이 발생합니다.
2. KV 캐시 가지치기 (KV Cache Pruning & Compression)
- 작동 원리: 수십만 토큰의 긴 문맥을 기억하려면 GPU의 고대역폭 메모리(HBM)가 기하급수적으로 소모됩니다. 서빙 엔진은 메모리 초과(OOM)를 방지하기 위해 ThinK나 FastKV 같은 알고리즘을 가동하여 중요도가 낮다고 추정되는 Key-Value 토큰 채널을 40~50% 강제 삭제합니다.
- 파급 효과: 앞선 지시사항이나 미세한 제약 조건(예: "반드시 JSON 형식으로만 답할 것", "특정 변수명 유지")을 망각하는 현상이 발생합니다.
3. 투기적 디코딩 탈락 (Speculative Decoding Dropout)
- 작동 원리: 속도를 높이기 위해 소형 보조 모델이 다음 토큰을 미리 예측하고 대형 모델이 한 번에 승인하는 파이프라인에서, 서버 부하가 한계에 달하면 이 검증 루프를 생략하거나 축소합니다.
- 파급 효과: 문맥의 정밀한 어휘 선택이 무너지고 획일적이고 기계적인 상투 문구가 증가합니다.
[실험 데이터로 입증된 성능 변화: 가짜 점수와 진짜 실무]
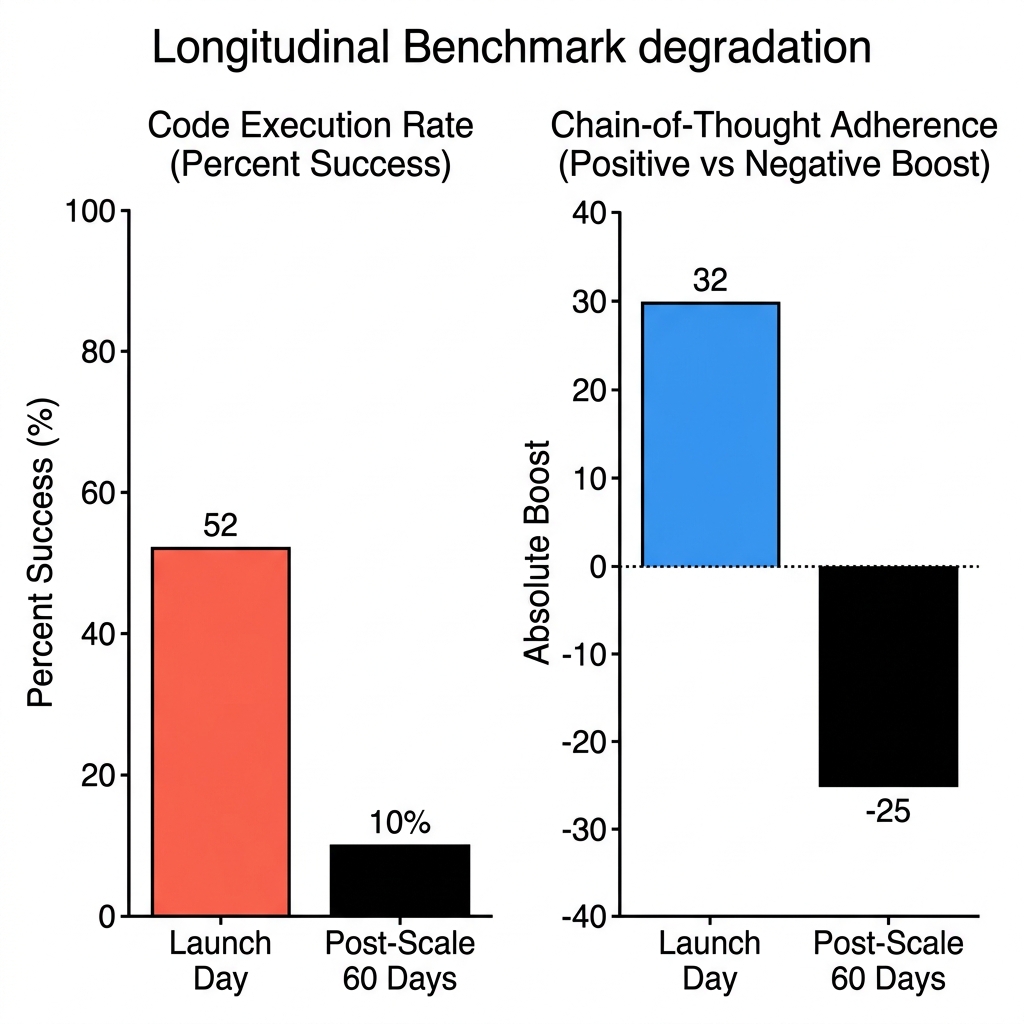
학술 연구진(스탠퍼드 및 UC 버클리 연구팀의 LLMDrift 연구)의 장기 추적 데이터는 커뮤니티의 의심이 단순한 착각이 아님을 수학적으로 증명합니다.
| 실무 평가 영역 | 출시 초기 (Day 1) | 서비스 스케일업 후 (Day 60+) | 실제 엔지니어링 파급 효과 |
|---|---|---|---|
| 코드 즉시 실행 성공률 | 52.0% 성공 | 10.0% 로 폭락 | 마크다운 따옴표 오류 및 문법 결함 급증 |
| 단계별 추론(CoT) 보너스 | +24.4% 정확도 향상 | -0.1% (오히려 하락) | '차근차근 생각하라'는 지시를 무시하고 단답화 |
| 수학 소수 판별 정확도 | 84.0% | 51.1% | 엄밀한 수식 연산의 신뢰도 붕괴 |
| 전문직 시험(USMLE) 일치율 | 86.6% | 82.1% (답변 불일치 12.2%) | 동일 질문에 대해 다른 오답을 도출 |
| 출력 형식 엄수율 (JSON) | 98.5% | 76.2% | 자동화 에이전트 파이프라인 파싱 에러 유발 |
[실생활 비유: 최고급 호텔 뷔페와 성수기 축소 운영]
이 현상은 실생활에서 '유명 호텔 뷔페의 성수기 메뉴 축소'와 매우 유사합니다:
- 오픈 초기: 손님이 적을 때는 최고급 생참치와 특제 디저트를 셰프가 직접 한 접시씩 정성껏 조리하여 내놓습니다. 음식의 맛과 디테일이 완벽합니다.
- 주말 만석(트래픽 피크): 대기 줄이 수백 미터로 늘어나면 호텔은 주방의 조리 시간을 줄이기 위해 생참치 대신 냉동 회를 내놓고, 수제 소스 대신 대용량 시판 드레싱을 씁니다. 손님은 여전히 같은 가격(월 구독료)을 지불하지만, 입맛이 예민한 미식가(숙련된 엔지니어)는 첫 숟가락에서부터 품질의 퇴보를 즉각 알아챕니다.
[법률 분석: EU 지침 2019/770 및 AI 규제법 대응]
사용자 몰래 서비스 품질을 낮추는 행위는 단순한 운영 기술을 넘어 법적 분쟁의 소지가 있습니다.
- 주관적·객관적 적합성 위반 (Directive 2019/770 Art. 7~8):
- 디지털 서비스는 사업자가 대외적으로 공표한 벤치마크 및 광고 내용과 합리적으로 기대되는 성능에 부합해야 합니다. '당사 최고의 코딩 인공지능'이라 홍보해 구독을 유치한 뒤 성능을 떨어뜨리는 것은 적합성 결여에 해당합니다.
- 일방적 서비스 변경 조항 (Article 19):
- 사업자가 서비스 내용을 변경할 경우, 반드시 영구 보존 가능한 매체(이메일 등)를 통해 소비자에게 사전에 명확히 고지해야 합니다. 소비자는 서비스 품질이 저하되었을 때 30일 이내에 위약금 없이 계약을 해지하고 잔여 기간을 전액 환불받을 법적 권리를 행사할 수 있습니다.
- EU AI Act(인공지능법)의 사후 모니터링 의무:
- 범용 AI(GPAI) 제공사는 서비스 출시 이후에도 성능 편차와 품질 드리프트를 투명하게 기록하고 감사 로그를 보관해야 할 법적 의무가 부과됩니다.
[실전 구현 제안: 4단계 엔터프라이즈 상시 모델 감사 프레임워크]
엔터프라이즈 환경에서 '스텔스 너프'로 인한 파이프라인 장애를 방지하기 위해, 팀 내부에서 직접 운용할 수 있는 의사코드(Pseudocode) 기반 자동화 감사 체계입니다.
[상시 모델 품질 감사기 작동 순서]
1. 매주 월요일 새벽 정기 감사 스케줄러가 기동합니다.
2. 출시 첫날 확정해 둔 표준 테스트 프롬프트 세트(코드 생성, JSON 파싱, 복합 추론 50건)를 로드합니다.
3. 무작위성을 차단하기 위해 온도(Temperature)를 0으로 고정하고 API를 호출합니다.
4. 반환된 응답을 바탕으로 4대 핵심 지표를 측정합니다:
   - [지표 1: 형식 엄수] JSON 스키마 및 마크다운 백틱 준수율 확인
   - [지표 2: 코드 실행] 자동 생성된 테스트 케이스의 빌드/테스트 통과율 확인
   - [지표 3: 응답 속도] 첫 번째 토큰 생성 시간(TTFT) 및 초당 토큰 생성량 측정
   - [지표 4: 일관성] 이전 주차 답변과의 텍스트 유사도 및 불일치율 계산
5. 측정 점수가 기준치보다 5% 이상 하락할 경우 엔지니어링 팀에 알림을 발송하고,
   중요 프로덕션 트래픽을 즉시 백업 클라우드 모델로 전환합니다.
[마무리: 신뢰할 수 있는 AI 시대를 위한 기업의 자세]
AI 모델은 정적인 소프트웨어 패키지가 아닌, 실시간으로 출렁이는 동적 클라우드 서비스입니다.
화려한 출시 벤치마크 마케팅에만 의존하던 시대는 끝났습니다. 이제 개발자와 엔터프라이즈는 자체적인 프롬프트 벤치마크 자산을 축적하고 지속적인 성능 감시 체계를 가동하여, 보이지 않는 성능 저하로부터 소프트웨어의 안정성과 비즈니스 가치를 스스로 지켜내야 합니다.
[참고 문헌]
- Stanford & UC Berkeley Research: How Is ChatGPT's Behavior Changing over Time? - Longitudinal LLMDrift Study (Chen, Zaharia, Zou)
- European Parliament & Council: Directive (EU) 2019/770 on Certain Aspects Concerning Contracts for the Supply of Digital Content and Digital Services (Arts. 7, 8, 14, 19)
- Salesforce AI Research & CUHK: ThinK: Query-Dependent Channel Pruning for KV Cache Compression in Long-Context LLMs (2025)
- DynaExq Systems Report: Runtime-Aware Precision Allocation and Dynamic MoE Demotion under Strict GPU Memory Budgets (2026)