구글 Gemini 4 vs 앤트로픽 Claude Opus 5.5: 프론티어 AI 모델 아키텍처와 엔터프라이즈 성능 전격 비교
[핵심 요약]
- 구글의 대반격: 구글 딥마인드가 TPU v6 Trillium 클러스터에서 처음부터 학습시킨 차세대 플래그십 Gemini 4 및 사이버 방어 특화 모델 Gemini 4 Argon을 전격 공개하며 프론티어 AI 경쟁의 판도를 뒤흔들었습니다.
- 스펙과 벤치마크의 대격돌: Gemini 4 Argon은 초당 125토큰(tok/s)의 초고속 추론 속도와 100만 토큰 연속 출력 기능, 100만 토큰당 1.20달러의 파격적인 단가로 Val AI 벤치마크 종합 1위를 기록했습니다. 반면 앤트로픽의 Claude Opus 5.5는 SWE-bench Pro 89.9%라는 역대 최고 소프트웨어 엔지니어링 신뢰도와 실무 코드 병합률(FrontierCode 91.2%)을 수성하고 있습니다.
- 엔터프라이즈의 선택 기준: 복잡한 저장소 단위의 대규모 코드 리팩토링에는 Claude Opus 5.5가, 대용량 실시간 컨텍스트 처리 및 비용 절감이 필수적인 에이전트 파이프라인에는 Gemini 4가 이상적인 대안으로 부상하고 있습니다.
[도입: 잠자던 거인의 기상과 뜨거워진 레딧 커뮤니티]
2026년 가을, 글로벌 AI 개발자 생태계를 뒤흔든 화두는 단연 구글의 차세대 플래그십 공개였습니다. 레딧 r/ClaudeAI 서브레디트에서는 추천수 1,090개를 돌파하며 열띤 토론이 촉발되었습니다:
"Gemini 4 is out: The competition has woken up. Do you think opus 5.5 will finally get some competition?"
(구글 Gemini 4가 공개되었습니다: 경쟁자들이 마침내 깨어났습니다. 이제 Opus 5.5도 진정한 적수를 만나게 될까요?)
그동안 Claude Opus 5.5와 Fable 5.1이 주도하던 소프트웨어 엔지니어링 시장에 구글이 TPU v6 Trillium 기반의 완전한 아키텍처 재설계 모델을 투입하면서, 프론티어 AI 모델의 헤게모니 경쟁은 새로운 국면에 진입했습니다.
[기술적 본질: 작동 원리 및 아키텍처 비교]
두 모델은 서로 다른 공학적 철학을 바탕으로 극한의 최적화를 달성했습니다.
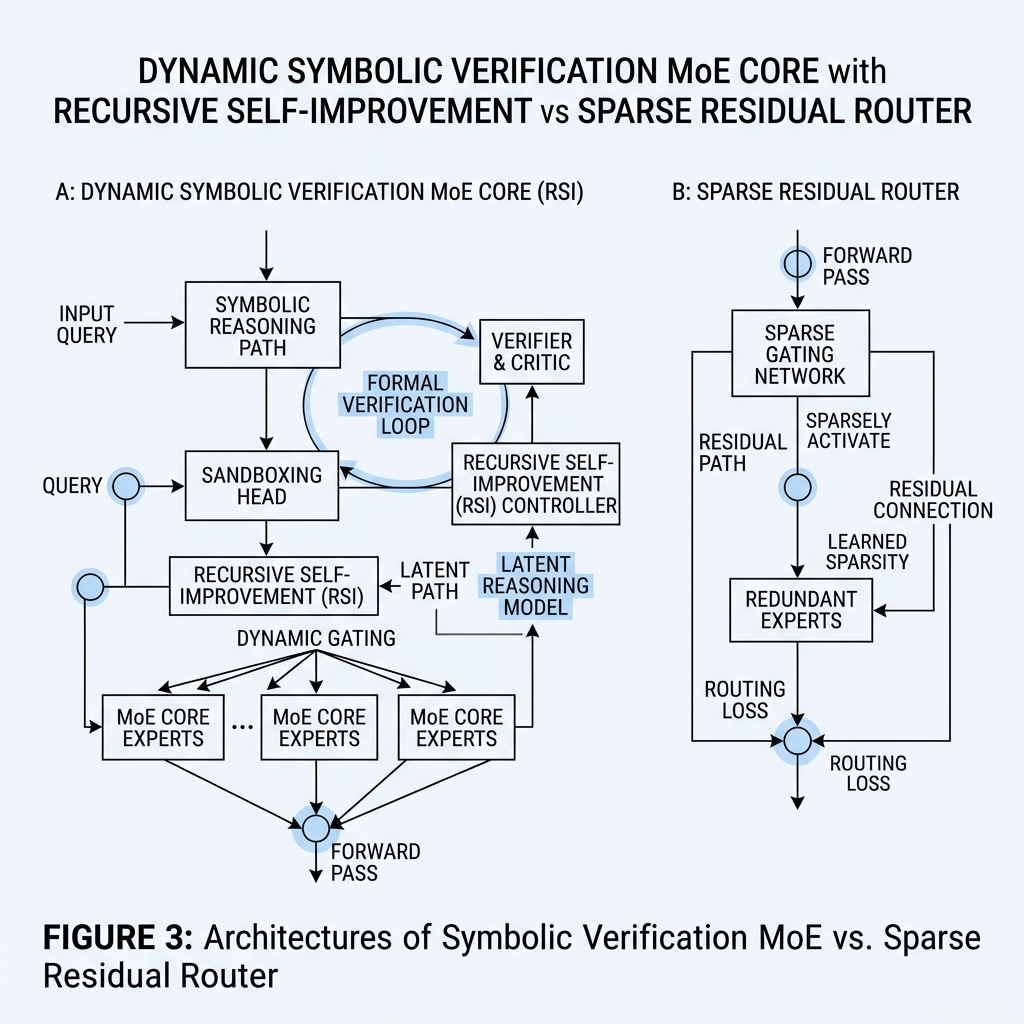
1. 구글 Gemini 4 Argon: 동적 기호 검증 MoE와 재귀적 자기 개선(RSI)
구글 딥마인드는 기존의 텍스트 트랜스포머에 외부 어댑터를 덧붙이던 설계를 완전히 폐기하고, 단일 어휘 표현을 공유하는 통합 멀티모달 확산 트랜스포머(Unified Multimodal Diffusion Transformer)를 구축했습니다.
- TPU v6 Trillium 전용 설계: 칩당 최대 4.7배의 연산 밀도를 제공하는 Trillium 클러스터와 광학 회로 스위칭(OCS)을 결합하여, 10만 개 칩 분산 환경에서 병목 없는 초고속 통신을 지원합니다.
- 재귀적 자기 개선 (Recursive Self-Improvement, RSI): AlphaProof 및 AlphaCode 3 연구에서 검증된 수학적 기호 검증 엔진을 사후 강화학습(RL) 루프에 내장했습니다. 모델이 추론하는 과정에서 격리된 마이크로 샌드박스(Sandbox) 헤드가 자동으로 단위 테스트를 실행하고, 실패 시 오차 신호를 즉각 잠재적 추론 경로로 역전파하여 논리적 환각을 원천 차단합니다.
- 압도적인 출력 한계: 1회 호출당 최대 1,000,000 토큰의 연속 출력을 지원하며, 적응형 엔트로피 KV 압축 기술을 통해 방대한 문맥에서도 연산 지연을 최소화합니다.
2. 앤트로픽 Claude Opus 5.5: 고밀도 추론 코어와 동적 메모리 압축
앤트로픽은 실무 개발 환경에서의 정밀한 코드 품질과 오류 없는 복합 명령 수행에 집중했습니다.
- 8비트 동적 KV-캐시 압축 (8-Bit Dynamic KV-Cache Compaction): 수십만 토큰의 문맥을 처리할 때 과거 토큰은 하드웨어 가속 INT8로 압축하고 핵심 주의 집중 토큰(Attention Sink)만 FP16 정밀도로 유지하여 GPU 메모리 대역폭 소모를 48% 절감했습니다.
- 2단계 투기적 디코딩 (Two-Tier Speculative Decoding): 소형 검증 모델이 4~6개의 후보 토큰을 초고속으로 예측하고 본 모델이 단일 병렬 패스로 검증하여, 프로그래밍 문법에서 86%의 적중률을 달성하며 생성 속도를 82 tok/s로 끌어올렸습니다.
- 궤적 압축 (Trajectory Compaction): 에이전트가 터미널 툴을 연속 호출할 때 성공한 중간 명령의 불필요한 출력 노이즈를 자동 제거하여 대화 문맥의 오염을 차단합니다.
[비교 테이블: 2026 프론티어 AI 핵심 지표 분석]
두 플래그십 모델의 핵심 스펙과 독립 평가 벤치마크 데이터를 대조 정리한 결과입니다:
| 평가 항목 | 구글 Gemini 4 Argon | 앤트로픽 Claude Opus 5.5 | 비고 및 시사점 |
|---|---|---|---|
| 추론 파이프라인 | Dynamic Symbolic MoE + RSI | Heavy Reasoning Core + GQA-32 | Gemini의 자동 검증 루프 vs Claude의 심층 추론 |
| 기반 하드웨어 | Google TPU v6 (Trillium) | NVIDIA Blackwell B200 / H100 | 구글의 자체 실리콘 수직 계열화 강점 |
| 최대 컨텍스트 | 기본 2M 토큰 (실험 10M) | 기본 500K 토큰 (베타 1M) | 대용량 코드베이스 통째 주입 가능 여부 |
| 최대 출력 토큰 | 1,000,000 토큰 | 128,000 토큰 | Gemini가 장편 소프트웨어 단일 생성 압도 |
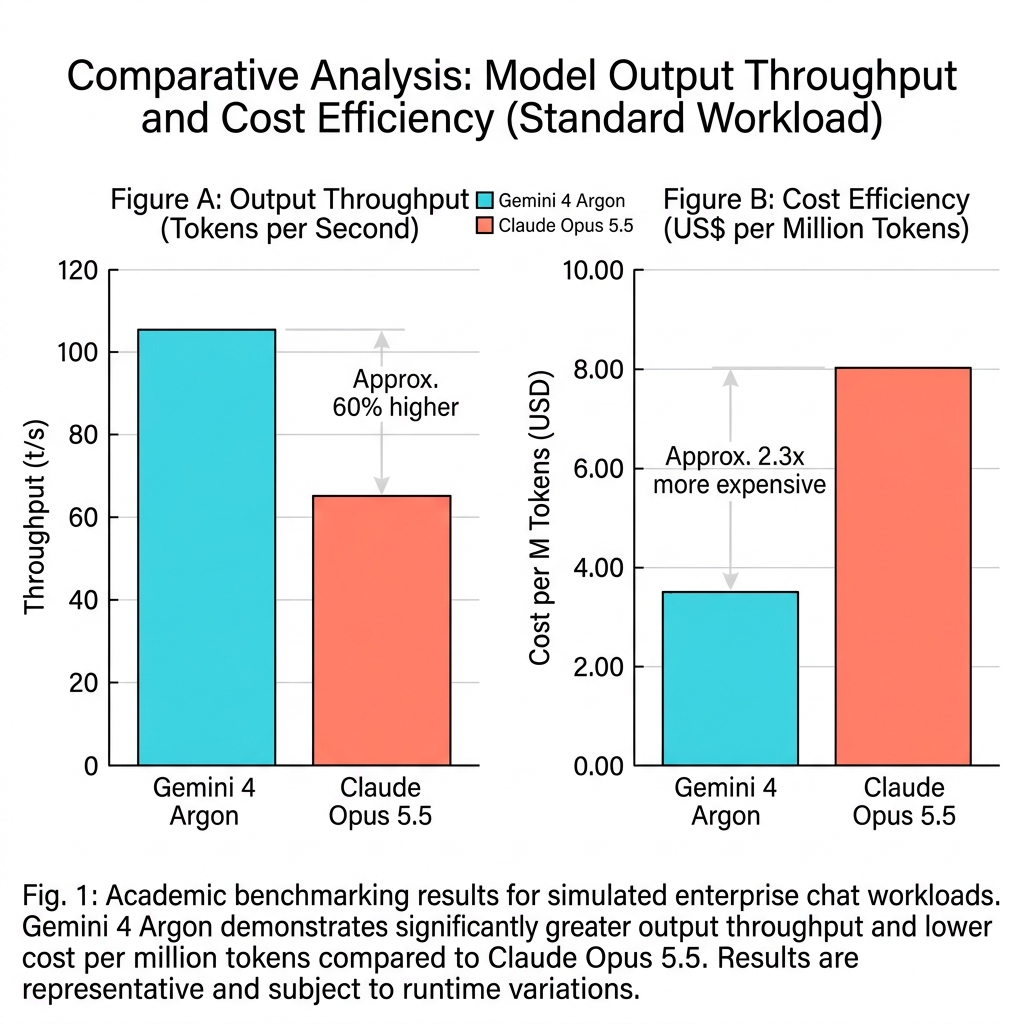
| 생성 속도 (TPS) | ~125 tokens/s | ~82 tokens/s | Gemini가 약 52% 더 빠른 출력 속도 달성 |
| 입력 단가 (1M 토큰) | $1.20 | $4.00 | Gemini가 70% 저렴한 비용 구조 |
| 출력 단가 (1M 토큰) | $4.80 | $20.00 | 고빈도 API 호출 시 비용 차이 극대화 |
| 프롬프트 캐시 할인 | 기본 입력가의 95% 감면 | $0.40 / 1M 토큰 | 반복 쿼리 시 두 모델 모두 파격 할인 |
| SWE-bench Pro | 78.4% (Verified) | 89.9% (업계 최고) | 실무 깃허브 버그 해결 정확도는 Claude 우세 |
| DeepSWE v1.1 | 77.9% (세계 신기록) | 74.2% | 복합 알고리즘 및 수학 결합 코딩 지표 |
| MMLU-Pro (추론) | 93.6% | 92.4% | 학술 및 전문 도메인 복합 지식 동등 |
| 접근성 및 배포 | Fairwind 사이버 방어 선행 잠금 | 즉시 멀티클라우드 (AWS, Azure, GCP) | 엔터프라이즈 즉시 도입은 Claude 우세 |
[실생활 비유: 고속 KTX와 정밀 수술 로봇]
이해를 돕기 위해 비유하자면 다음과 같습니다:
- Gemini 4 Argon은 수천 킬로미터의 전용 철로(TPU v6 OCS 네트워크) 위를 시속 300km로 질주하는 최신 고속 KTX 열차와 같습니다. 거대한 양의 화물(200만 토큰)을 한 번에 싣고 가장 저렴한 운임으로 목적지까지 순식간에 수송합니다.
- Claude Opus 5.5는 수백 개의 미세 센서와 피드백 루프를 갖춘 정밀 미세 수술 로봇과 같습니다. 속도나 대량 운송보다는 한 치의 오차도 허용되지 않는 복잡한 심장 수술(대규모 레거시 코드베이스의 경쟁 상태 및 모듈 결합 버그 해결)에서 결함률 0%에 가까운 안정성을 제공합니다.
[트레이드 오프 및 병목 구간 진단]
실제 서비스 도입 시 고려해야 할 현실적인 한계와 기회비용입니다:
- Gemini 4의 도입 장벽과 공급 제약:
- 구글은 자율 제로데이 취약점 발견률(84.6%)과 FTC의 엄격한 엔터프라이즈 책임 원칙으로 인해, 초기 출시 대상을 Fairwind 사이버 보안 프로그램 승인 기관으로 한정했습니다. 일반 엔터프라이즈 상용 API가 전면 개방되기까지는 시차가 존재합니다.
- Claude Opus 5.5의 서빙 비용 및 파라미터 강제:
- Opus 5.5는 이전 세대보다 40% 저렴해졌지만 100만 출력 토큰당 20달러의 비용은 대규모 트래픽에서 여전히 부담입니다. 또한 '생각하기(Extended Thinking)'가 상시 활성화되어 있어 즉각적인 단답형 응답이 필요한 단순 라우팅 용도로는 지연 시간이 발생합니다.
[실전 구현 제안: 2단계 지능형 하이브리드 라우터 설계]
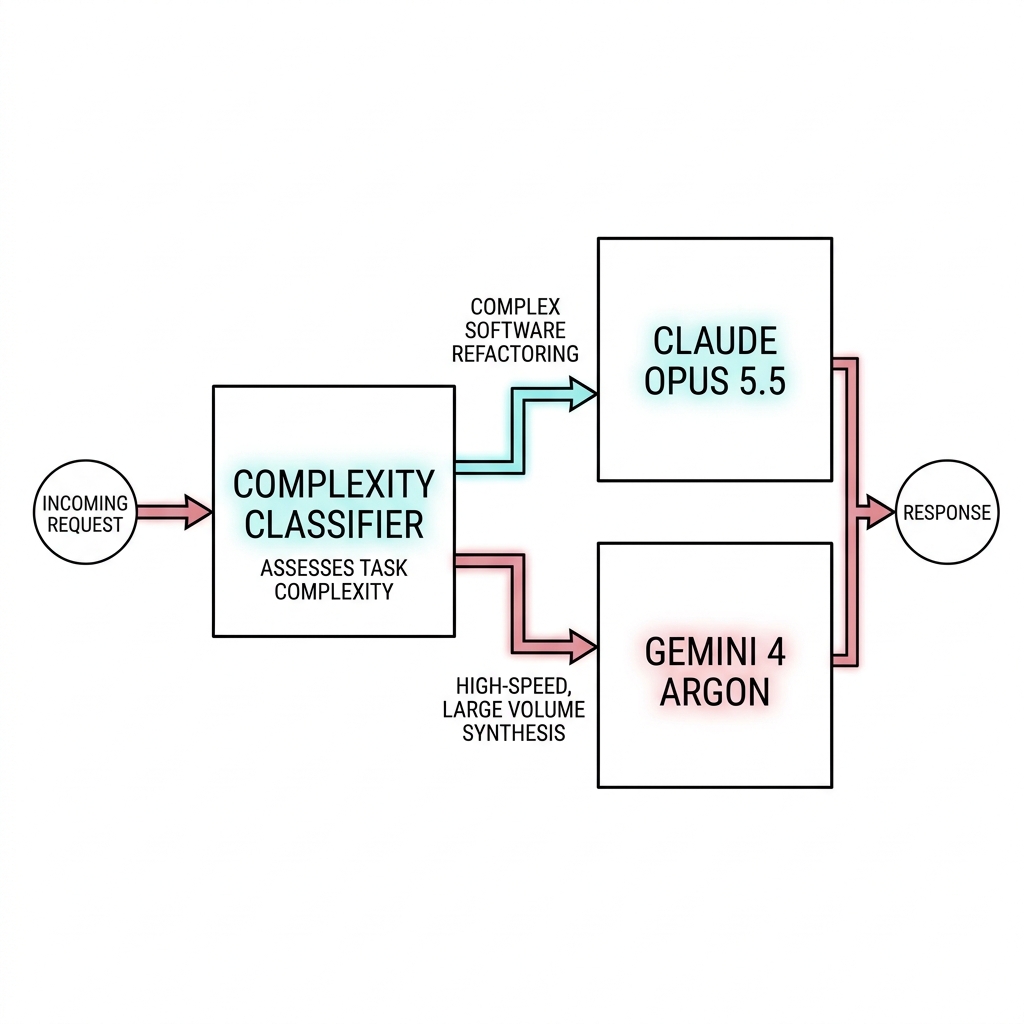
두 모델의 장점만을 극대화하기 위해, 실제 프로덕션 파이프라인에서는 작업의 성격에 따라 요청을 자동으로 분기하는 의사코드(Pseudocode) 기반의 라우팅 시스템을 권장합니다.
[지능형 AI 모델 라우터 처리 단계]
1. 사용자로부터 요청 작업과 코드베이스 컨텍스트를 수신합니다.
2. 경량 분석기가 코드 복잡도와 예상 토큰 길이를 측정합니다:
   - 복잡한 모듈 간 참조, 아키텍처 리팩토링, 엄격한 단위 테스트 작성인 경우:
     -> [Claude Opus 5.5]로 라우팅 (정밀 추론 모드 가동)
   - 10만 줄 이상의 로그 분석, 대용량 문서 요약, 단순 보일러플레이트 고속 생성인 경우:
     -> [Gemini 4 Argon]으로 라우팅 (고속 대용량 모드 가동)
3. 응답 결과의 스키마 및 문법 오류 여부를 자동 검증합니다.
4. 만약 특정 제공사 엔드포인트에서 429(속도 제한)나 지연이 발생하면 자동으로 상호 백업 경로로 페일오버합니다.
5. 최종 가공된 결과를 사용자에게 반환합니다.
[마무리: 2026 프론티어 AI의 미래 가치]
구글의 Gemini 4 출시는 프론티어 AI 모델 시장이 '단일 승자 독식'에서 '특화된 하이엔드 양자 대결' 구조로 재편되었음을 알리는 명백한 신호탄입니다.
개발팀과 엔터프라이즈는 더 이상 특정 벤더에 종속되지 않고, 초고속·초대용량 처리의 Gemini 4와 무결점 엔지니어링 신뢰도의 Claude Opus 5.5를 파이프라인의 양 날개로 삼아 비용은 60% 절감하면서도 프로덕트 완성도를 극대화하는 멀티 에이전트 전략을 선제적으로 취해야 할 시점입니다.
[참고 문헌]
- Google DeepMind 공식 기술 발표: Gemini 4 Argon Neural Architecture & TPU v6 Trillium Benchmark Overview (2026.09)
- Anthropic 공식 엔지니어링 리포트: Claude Opus 5.5 Architecture, SWE-bench Pro Verification & Pricing Guide (2026.09)
- Vals AI Benchmark Labs: Frontier Model Throughput, Cost per Million Tokens and Accuracy Rankings (2026.10)
- CodeRabbit Engineering Audit: Autonomous PR Review and Bug Coverage Analysis of Frontier Models (2026)